AIでサイバー攻撃を「割に合わなく」する。動的防御とリスク評価の自動化
 m.uchiki
AI時代のサイバーセキュリティを「損得勘定」で考える|第3回:AIによる実現と効果測定
このブログの連載を書いている間にも、個人情報の流出事件はどんどん増加し、もはや日本人では、個人情報が流出していない人の方がレアかもしれません…
流出したものは取り返しがつかないので、今後に備え、企業/組織には、これまでの惰性や慣習ではない考え方に基づくセキュリティ強化をお願いしたいです。
第1回では、攻撃者の期待利益と実現利益を下げる防御戦略を考えました。
第2回では、企業/組織のセキュリティリスクを期待損失額で捉え、投資を経済合理的に判断する方法を整理しました。
では、それらを実現するために、防御側は何を変えるべきでしょうか。
攻撃者に手間をかけさせるために、防御側がそれ以上の手間をかけるのでは、本末転倒です。
攻撃者がAIで効率化する時代に、防御側はどのように対抗すればよいのでしょうか?
今回は、対抗手段の具体的な仕組みとAIの使い方について、お話しします。
なお、この記事に関する免責事項は、末尾に掲載されているリンク先に記載されていますので、ご確認ください。
先に結論だけ
攻撃者がAIで効率化する時代に、防御側はどのように対抗すればよいのでしょうか?
AIで攻撃側の仕事を増やし、防御側の仕事を減らす。
その成果を数字で確かめ、投資判断に戻す。
AIに期待する役割は、大きく2つあります。
1つは、おとりや継続的な変化を維持する手間を減らすこと。
もう1つは、膨大なリスクの洗い出しと金銭評価を支援することです。
ただし、AIにすべてを任せるわけではありません(AIは責任を取れない)。
実行の再現性を確保し、最終的な責任を人間と組織が担うことが前提です。
ここで述べるのは、既存技術を基にした活用コンセプトであり、導入効果を実証済みとするものではありません。
「継続的に変化させる」「嘘を混ぜる」という防御
第1回で示した4つの防御戦略のうち、今回は「攻撃コストを上げる」という領域を掘り下げます。
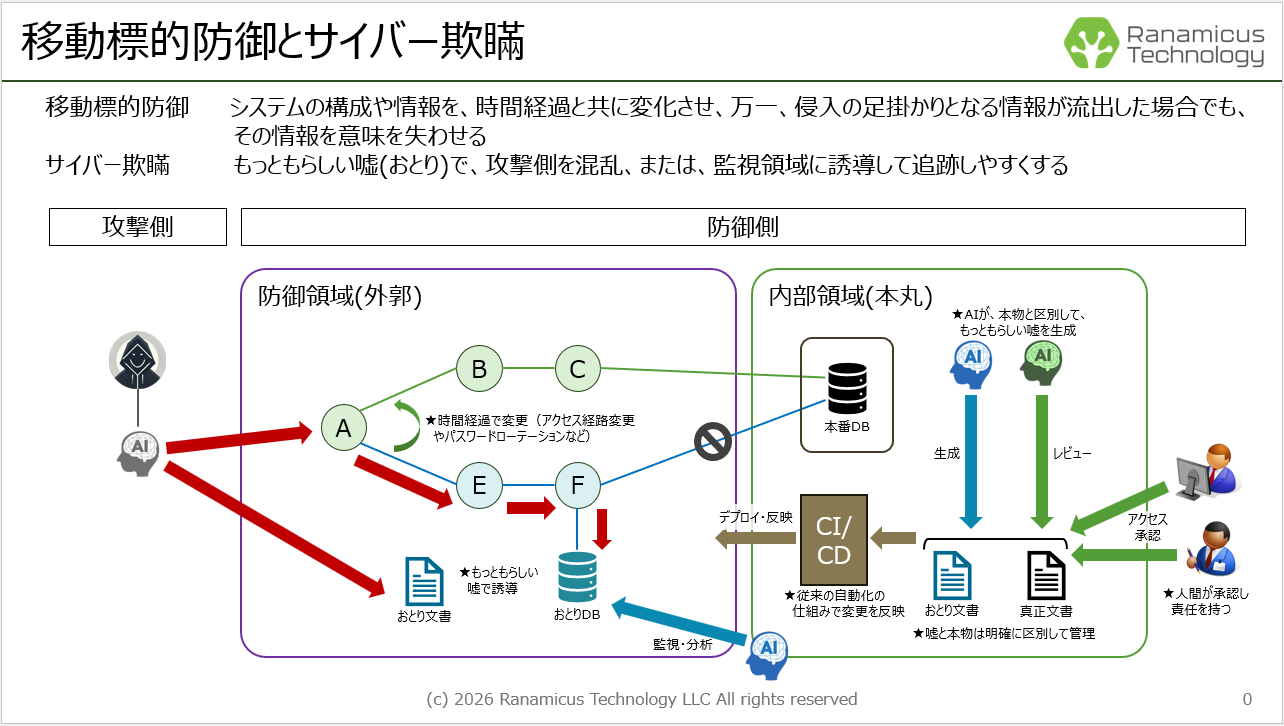
攻撃側が調べた情報を古くするMoving Target Defense(移動標的防御)と、攻撃側を誤誘導するCyber Deception(サイバー欺瞞)の組合せです。
例えば、企業/組織のシステムへ侵入した攻撃者が、重要そうなデータベースの接続情報を発見したとします。
攻撃者は、その情報を使って接続し、テーブルを調査し、情報を盗み出そうとするかもしれません。
しかし、その接続情報が、実は防御側が用意したおとりだったとしたら、どうでしょうか。
攻撃者は価値のない情報の調査に時間を費やし、おとりへの接続を監視していれば、防御側は攻撃活動を検知することもできます。
同じ発想で、架空の機密資料、おとりクラウド認証情報、偽の管理用API、隔離されたおとりサーバなども考えられます。
さらに、おとりの内容や配置を適切に変化させれば、攻撃者は一度調査した情報が現在も正しいのか、再確認しなければなりません。
つまり、攻撃側に調査・判断・検証を繰り返させるわけです。
もちろん、ただ嘘の情報を大量に置けばよいわけではありません。
自然で整合性のあるおとりでなければ、すぐに見破られるでしょう。
また、おとり環境は本番から分離し、本物の業務データに偽情報を混ぜたり、おとりから本番へ侵入できたりしないようにする必要があります。
ただし、変化させる対象やタイミングによっては、本来のサービスに影響が生じます。
また、攻撃側が調査に時間を使っても、本番環境の侵害が続いていれば効果は限定的です。
おとりへの誘導と実際の被害低減は、区別して、それぞれ評価する必要があります。
AIを活用して、防御の運用コストを下げる
さて、ここまで読んでいただくと、もう1つ問題があることに気づくかもしれません。
おとりを継続的に作成・更新し、その整合性を保つには、かなりの手間がかかります。
攻撃側に手間をかけさせるために、防御側がそれ以上の手間をかけてしまっては、本末転倒です。
そこで、生成AIやAI Agentの活用を考えます。
例えば、以下のような仕組みです。
- AIが構成情報や検知ログを分析する
- AIがおとりの文書や環境構成の変更案を生成する
- 変更内容をルールに照らして検証し、人間が必要な承認を行う
- IaCやCI/CDで変更内容を展開する
- 検知結果や運用コストを評価し、次の改善に反映する
IaC(Infrastructure as Code)はサーバやネットワークの構成をコードで管理する方法、CI/CDは変更の検証や環境への反映などを自動化する仕組みです。
ただし、AIにすべてを任せず、AIが得意な分析・生成と、従来の自動化が得意な再現可能な実行とを分け、人間の統制を効かせることが重要です。
生成AIは、柔軟な分析や新しい案の作成が得意ですが、判断を誤ることがあります。
例えば、AIの誤判断をもとにネットワーク設定を変えれば、セキュリティ強化のつもりでシステム障害を引き起こす可能性もあります。
そして、AIがその結果に対する責任を持ってくれるわけではありません。
最終的な責任は、それを導入・運用する人間と組織が持つのです。
従来の自動化も設定やプログラムを誤れば問題を起こしますが、変更可能な範囲、事前テスト、承認、監査ログ、ロールバック(問題発生時に元の状態へ戻す処理)を組み込むことで、実行を管理しやすくなります。
また、今回の仕組みでは、AIが攻撃者の操作したログやデータを読む可能性があります。
そこにAIへの不正な指示が紛れ込んでいれば、AIの判断を誘導するプロンプトインジェクションが起こり得ます。
例えば、ログ中の悪意ある文字列をAIが指示だと誤解し、不適切な構成変更を提案してしまうケースです。
だからこそ、AIの提案を自動的に本番へ反映させない仕組みが重要になります。
生成する対象は、おとりを中心とした管理された範囲に限定し、本番業務データに偽情報を混ぜないことも前提です。
また、AIが生成したおとりや偽の構成情報を、防御側のメンバーが本物と誤認し、設計・構築・運用などに混乱を招くおそれもあります。
そのため、防御側内部では、Single Source of Truth(信頼できる唯一の情報源)を原則としたドキュメント管理を、従来以上に徹底する必要があります。
本番環境の正規情報と、おとり・偽情報を明確に分離し、それぞれの管理元と更新責任を明確にすることが重要です。
なお、おとりであることを識別するための管理情報は、攻撃側に知られないよう、適切にアクセス制御する必要があります。
また、AI利用料やレビュー工数、隔離・監視コストを含めても、従来方式より経済合理的かどうかを確かめる必要があります。
AIを活用して、セキュリティリスクを定量評価する
ここまで、AIを使って防御側の作業コストを下げる話をしてきました。
しかし、AIが役立ちそうな領域は、もう1つあります。
それが、第2回で登場したモデルCで使うセキュリティリスクの洗い出しと定量評価です。
企業/組織のセキュリティリスクは、業務、システム、拠点、取引先、利用者、脆弱性、攻撃手法などによって膨大な組み合わせになります。
発生確率や被害額を、人間だけで一つひとつ推計するのは、現実的ではありません。
そこで、AIを次のように活用することを考えます。
自社/自組織の情報を正しく提供する
同じ攻撃手法でも、企業/組織によって発生確率も被害規模も異なります。
例えば、対象システムの公開範囲、顧客情報の種類・件数、ネットワーク構成、アクセス権限、既存の対策、バックアップ・復旧能力、取引先との依存関係などによって、リスクは大きく変化します。
したがって、AIには一般的な脅威情報だけでなく、自社の資産台帳、システム構成、業務影響、対策状況、インシデント履歴などの正確で新しい情報を与える必要があります。
もちろん、これらは機密情報です。
AIに読み込ませる範囲、権限、外部サービスへの送信可否などは、適切に管理しなければなりません。
リスク項目の洗い出しとスクリーニングも依頼する
人間が最初からリスク一覧を完成させるのではなく、AIに攻撃経路や被害シナリオを提案させ、似た項目を整理し、一次的な評価を行わせます。
その際、重要なのは「リスク名」だけでなく、どの資産に、どのような事象が起こり、どういう被害につながるかまでを具体化することです。
例えば「顧客情報漏洩」だけではなく、「公開Webアプリの脆弱性を突かれ、顧客データを外部へ持ち出される」といったシナリオにします。
こうすれば、発生確率、成功確率、被害額、対応費用を、モデルCへ入力しやすくなります。
ただし、AIが洗い出した一覧に漏れがある可能性もあります。
既存のリスク分類や現場担当者の知見とも照合しましょう。
推定値だけでなく、必ず根拠を示させる
例えば、AIが「年間の攻撃成功確率は1%」と出してきたら、その1%はどこから来たのでしょうか。
過去のインシデント実績なのか、脅威情報の統計なのか、自社の対策状況を踏まえた推論なのか。
対象期間や母集団は合っているのか。
この説明がなければ、数字だけが立派でも経営判断には使えません。
そこで、各リスクについて、推定値、使用データ、情報源、計算・推論方法、前提条件、情報が不足している点をセットで提示させます。
十分な根拠がない場合には、「推定不能」「追加調査が必要」と明示することも重要です。
推定の不確実性と、評価できていない損失も示す
第2回では、期待損失額(想定損失額)の基本推定値と、上側評価額を区別しました。
AIによる定量評価でも、この違いを保ちます。
攻撃が発生するかどうかという不確実性と、推定値そのものの信頼性を混同しないためです。
特に被害額は、計算方法がもっともらしくても、重要な損失項目を見落としている可能性があります。
例えば、AIが企業破綻の損失を時価総額に基づいて推定した場合、人間は補償責任や事業停止の影響など、対象範囲から漏れたものがないか検討します。
必要な損失は再推計させ、逆に重複する項目は除外します。
AIが出した数字が正しいとは限りません。
データ、前提、計算方法、評価範囲、不足情報を、一緒に示すことが重要です。
AIに推定させ、人間が判断する
このように整理すると、AIを活用した実務上の流れは以下のようになるでしょう。
- 人間が、自社/自組織の資産・システム・業務・対策情報を整える
- AIが、リスクシナリオを洗い出し、一次スクリーニングする
- AIが、発生確率・被害額・対応費用を推定し、根拠を示す
- AIが、推定の不確実性と、情報不足を明示する
- 人間が、重要な推定を検証し、必要に応じて追加調査する/指示する
- AIが、あらかじめ開発・検証した定量評価ツールを用いて、組織全体のリスクを集計し、対策案を比較する
- 人間が、経営として、リスク受容と投資判断を行う
AIはリスクの発見・推定・根拠整理を支援し、計算は検証可能な仕組みで実施し、最終的なリスク受容と投資判断は、人間と組織が担う。
これが基本方針です。
また、AIを利用する費用や、評価結果を検証する人間の工数も、モデルCの平常時コストに含めて評価します。
AIを使うこと自体が目的になっては、意味がありません。
防御戦略の効果を、どう測定するか?
最後に、もう1つ重要なのが、効果測定です。
セキュリティ製品を何種類導入したか、ルールを何件増やしたかだけでは、対策の効果を十分には説明できません。
本当に知りたいのは、攻撃側の利益と、防御側のセキュリティリスク・コストが、対策によってどのように変化したかです。
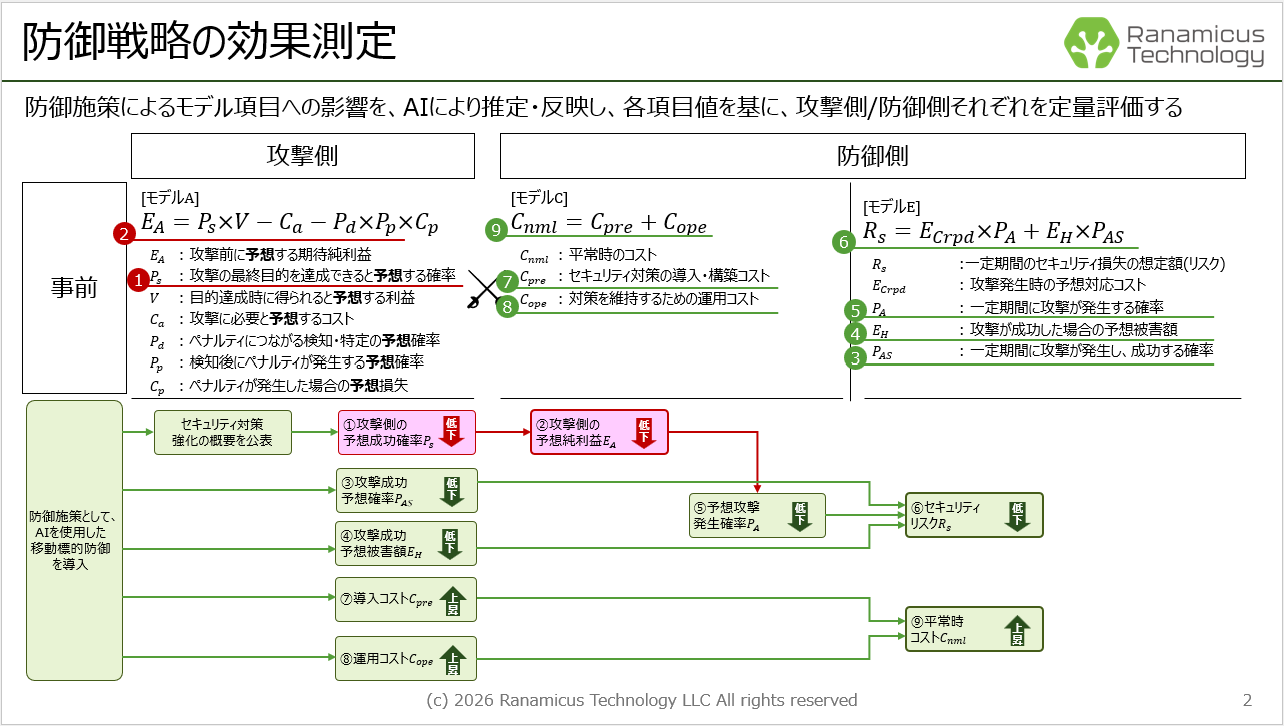
そこで、これまで説明してきた攻撃側のモデルA・Bと、防御側のリスク・コストモデルC・D・Eについて、それぞれの構成要素を測定・推定し、数式から評価値を導出することを考えます。
| 評価対象 | 測定する項目 | 測定/推定の考え方 |
|---|---|---|
| モデルA:攻撃前の期待利益 \( E_A \) | 攻撃成功の予想確率 \( P_s \) 成功時の予想価値 \( V \) 予想攻撃コスト \( C_a \) 検知・特定の予想確率 \( P_d \) ペナルティ発生予想確率 \( P_p \) 予想ペナルティ \( C_p \) | いずれの測定項目も、防御側が把握することは困難。 攻撃側の立場(※)を模したAIに、外部から観測可能な情報だけで推測させる。 |
| モデルB:攻撃後の実現利益 \( G_A \) | 実際に得られた価値 \( R_A \) 実際の攻撃コスト \( C_A \) 実際に被った損失・ペナルティ \( L_A \) | いずれの測定項目も、防御側が把握することは困難。 攻撃側の立場(※)を模したAIに、脅威情報、過去の攻撃事例、許可された模擬攻撃などの結果を用いて推定させる。 |
| モデルC:防御側の平常時コスト \( C_{nml} \) | 対策の導入・構築費用 \( C_{pre} \) 運用費用 \( C_{ope} \) | セキュリティ対策に当てる予算と実績値を用いる。 |
| モデルD:防御側の実際対応コスト \( C_{inc} \) | 実際の被害額 \( H \) 実際の対応費用 \( C_{rpd} \) | 実際に攻撃を受け、被害を被った実績がある場合は、その攻撃シナリオの実績値として使用する。 実際に攻撃が発生していない場合は、想定として、モデルEの予想被害額 \( E_H \)、予想対応費用 \( E_{Crpd} \)で評価する |
| モデルE:防御側のセキュリティリスク \( R_s \) | 攻撃発生確率 \( P_A \) 攻撃成功確率 \( P_AS \) 成功時の予想被害額 \( E_H \) 予想対応費用 \( E_{Crpd} \) | 攻撃発生確率 \( P_A \)は、上記\( E_A \)の参考値として、攻撃側の立場(※)を模したAIに、実際に攻撃に踏み切る確率を推定させる。 攻撃成功確率 \( P_{AS} \)、成功時の予想被害額 \( E_H \)、予想対応費用 \( E_{Crpd} \)は、防御側AIに対して、内部情報や、過去事例、模擬攻撃・復旧演習などの結果を入力として、推定させる。 |
※攻撃側の立場は、その目的・攻撃能力に応じたいくつかの種類を想定する
ただし、防御側では、攻撃側の推測や実際の攻撃の損益を把握することは、通常できません。
モデルAは攻撃側の事前予想を表すものですが、攻撃側がどの程度の利益やコストを予想しているかを、防御側が正確に把握することは困難です。
モデルBについても、攻撃側が実際に得た利益、投入したコスト、被ったペナルティを正確に知ることはできません。
そのため、攻撃側の目的に応じた種類を想定し、脅威情報、過去の攻撃事例、許可された模擬攻撃などの結果を用いて、各項目を推定することになります。
例えば、模擬攻撃によって、攻撃に必要な作業時間や、目的達成の難易度を評価できます。
これらは攻撃コストや成功確率を推定するための参考情報になりますが、実際の攻撃者の損益そのものではありません。
また、モデルBの実績値が把握できない場合(多くの場合)には、モデルAの予想価値 \( V \) や予想ペナルティ \( C_p \) なども参考にできます。
ただし、事前の予想と事後の実績は異なるため、観測できた事実と仮定に基づく推定値を区別し、観測できた事実があれば優先して使用します。
特に、実際の攻撃が発生していない場合、モデルBについて算出できるのは、想定した攻撃シナリオに基づく推定結果であり、実績ではありません。
一方、防御側の平常時コストは、実際の導入費用や運用実績から、比較的正確に把握できます。
セキュリティリスクについては、第2回で説明したように、発生確率・被害額・対応費用を推定し、期待(想定)損失額を算出します。
このように、実測可能な項目は実績を使用し、直接測定できない項目は合理的な根拠に基づいて推定するという考え方です。
そして、同じ攻撃シナリオや評価条件の下で、対策前後のモデルの評価値を比較します。
例えば、AIを活用しておとりを継続的に更新することで、模擬攻撃に必要な作業時間が増加したとします。
これを攻撃コストの推定に反映することで、攻撃者の期待利益 \( E_A \) が、どの程度低下するかを評価できます。
ただし、攻撃前の判断への効果を考える場合は、攻撃者がその防御を認識しているかどうかも考慮する必要があります。
また、重要資産への到達確率や想定被害額が下がったのであれば、防御側のセキュリティリスク \( R_s \) に、その効果を反映できます。
もちろん、そのためにAI利用料や監視費用、運用工数などが増えた場合には、平常時コスト \( C_{nml} \) に反映します。
評価に使用した推定値や根拠、不確実性についても記録し、対策前後で比較条件が変わっていないか確認します。
また、おとりへ攻撃者を長時間誘導できたとしても、その間に本番環境の被害が拡大するのであれば、成功した対策とは言えません。
重要なのは、攻撃者の損益と防御側のリスク・コストを、共通の評価モデルに基づいて定量化し、対策の効果を検証することです。
まとめ――AI時代に目指すべきセキュリティ対策
最初に提示した結論を、もう一度確認します。
攻撃者がAIで効率化する時代に、防御側はどのように対抗すればよいのでしょうか?
AIで攻撃側の仕事を増やし、防御側の仕事を減らす。
その成果を数字で確かめ、投資判断に戻す。
第1回では、攻撃側にとって「割に合わない」環境を作り、侵入されても目的を達成させないという戦略を考えました。
第2回では、発生確率と金銭換算した被害を基に、企業が許容できるリスクを、合理的な費用で実現する考え方を整理しました。
本記事で示したAI活用は、その2つを実行し、継続的に改善するための手段です。
おとりや動的防御の生成・変更を支援し、攻撃側の調査コストを増やす。
一方で、膨大なリスクシナリオの整理や、損失額推定の根拠づくりを支援する。
いずれも防御側の負担を抑えることを目指しています。
ただし、AIが生成した対策や推定値は、それだけで信頼できるわけではありません。
AIの柔軟な分析・生成、従来型自動化の再現性、人間による検証と統制を組み合わせることが欠かせません。
そして効果は、攻撃側にかけさせた手間だけではなく、実際の被害と防御側コストの変化によって評価します。
攻撃側にとっては「割に合わない」、防御する企業にとっては「リスクとコストのバランスが取れた」セキュリティ対策
その実現こそ、AI時代に目指すべき方向性の1つではないかと考えます。
免責事項
Follow me!